- تشخیص الگوی 101: نحوه پیکربندی الگوریتم AI خود با قوانین ، وقایع و شرایط منظم
- کامپوزیت چیست؟
- آیا چیزی مانند "قیمت مناسب" برای محصولات شما وجود دارد؟
- ارزیابی های تجاری با استفاده از نسبت قیمت/درآمد (P/E)
- شرکت های بزرگی که پرداخت های رمزنگاری را می پذیرند
- عملکرد از دست دادن آنتروپی متقابل
- راهنمای معدن تن
- تأثیرگذارترین سرمایه گذاری
- Changelly Review 2023
- بازار سهام امروز: سهام نزدیک به آوریل در سالها با یک اسلاید دیگر
آخرین مطالب
امکانات وب


[xl ، yl] = plsregress (x ، y ، ncomp) بارهای پیش بینی کننده و پاسخ xl و yl را به ترتیب برای رگرسیون حداقل مربعات جزئی (pls) پاسخ ها در ماتریس y بر روی پیش بینی کننده ها در ماتریس X ، با استفاده ازاجزای NCOMP PLS.
- پیش بینی کننده نمرات XS را کسب می کند. نمرات پیش بینی کننده اجزای PLS هستند که ترکیب خطی متغیرها در x هستند.
- پاسخ ys. نمرات پاسخ ترکیبی خطی از پاسخ هایی است که اجزای PLS با آن حداکثر کواریانس دارند.
- یک بتا ماتریس از برآورد ضریب برای رگرسیون PLS. PlsRegress ستونی از موارد را در ماتریس X اضافه می کند تا تخمین های ضریب را برای یک مدل با شرایط ثابت (رهگیری) محاسبه کند.
- درصد واریانس PCTVAR توسط مدل رگرسیون توضیح داده شده است.
- میانگین خطاهای مربع تخمین زده شده MSE برای مدل های PLS با اجزای NCOMP.
- آمار ساختاری که حاوی وزن PLS ، آمار t 2 ، و باقیمانده های پیش بینی کننده و پاسخ است.
[xl ، yl ، xs ، ys ، بتا ، pctvar ، mse ، stats] = plsregress (___ ، نام ، مقدار) علاوه بر هر یک از ترکیبات آرگومان ورودی در نحوهای قبلی ، گزینه ها را با استفاده از یک یا چند آرگومان ارزش نام مشخص می کند. آرگومان های ارزش نام پارامترهای محاسبه MSE را مشخص می کنند. به عنوان مثال ، "CV" ، 5 MSE را با استفاده از اعتبار سنجی متقاطع 5 برابر محاسبه می کند.
مثال ها
رگرسیون حداقل مربعات جزئی را انجام دهید
مجموعه داده های طیف را بارگیری کنید. پیش بینی X را به عنوان یک ماتریس عددی که حاوی شدت طیفی مادون قرمز نزدیک (NIR) از 60 نمونه بنزین در طول موج 401 است ، ایجاد کنید. پاسخ y را به عنوان یک بردار عددی ایجاد کنید که حاوی رتبه های اکتان مربوطه باشد.
بارطیفx = nir ؛y = اکتان ؛رگرسیون PLS را با 10 مؤلفه پاسخ در Y در پیش بینی کننده در x انجام دهید.
[xl ، yl ، xs ، ys ، beta ، pctvar] = plsregress (x ، y ، 10) ؛
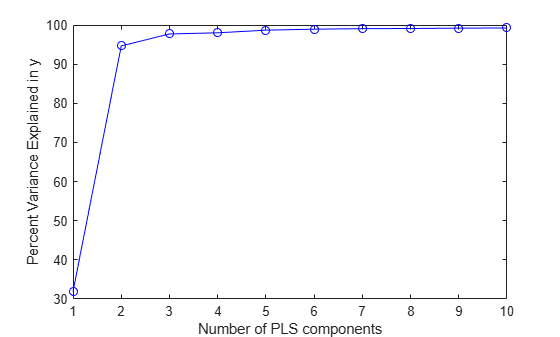
درصد واریانس توضیح داده شده در متغیر پاسخ (PCTVAR) را به عنوان تابعی از تعداد مؤلفه ها ترسیم کنید.
طرح (1: 10 ، cumsum (100*pctvar (2 ، :)) ،'-bo') ؛xlabel ("تعداد اجزای pls") ؛ylabel ("واریانس درصد توضیح داده شده در y");
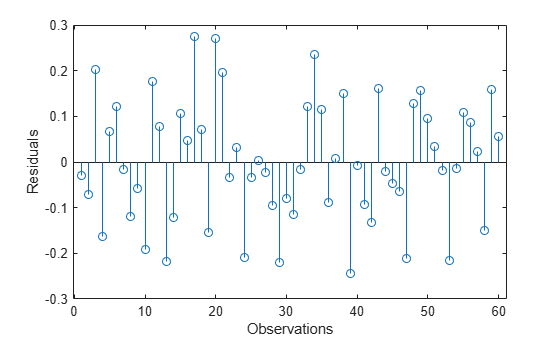
پاسخ متناسب را محاسبه کرده و باقیمانده ها را نمایش دهید.
yfit = [اندازه (اندازه (x ، 1) ، 1) x]*بتا ؛باقیمانده = y - yfit ؛ساقه (باقیمانده) xlabel ("مشاهدات") ؛ylabel ("باقیمانده");
اهمیت متغیر را در طرح ریزی برای رگرسیون PLS محاسبه کنید
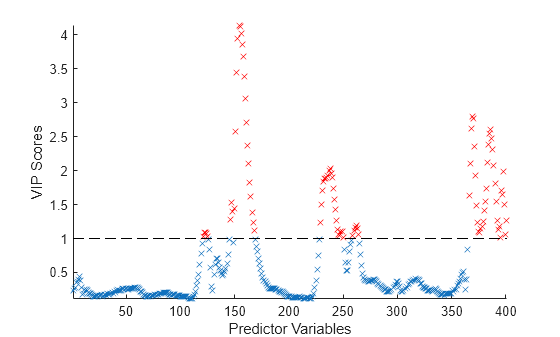
اهمیت متغیر را در نمرات طرح ریزی (VIP) برای یک مدل رگرسیون حداقل مربعات جزئی (PLS) محاسبه کنید. در صورت وجود چند قطبی در بین متغیرها ، می توانید از VIP برای انتخاب متغیرهای پیش بینی کننده استفاده کنید. متغیرهای دارای نمره VIP بیشتر از 1 برای پیش بینی مدل رگرسیون PLS مهم هستند [3].
مجموعه داده های طیف را بارگیری کنید. پیش بینی X را به عنوان یک ماتریس عددی که حاوی شدت طیفی مادون قرمز نزدیک (NIR) از 60 نمونه بنزین در طول موج 401 است ، ایجاد کنید. پاسخ y را به عنوان یک بردار عددی ایجاد کنید که حاوی رتبه های اکتان مربوطه باشد. تعداد مؤلفه های NCOMP را مشخص کنید.
بارطیفx = nir ؛y = اکتان ؛NCOMP = 10 ؛رگرسیون PLS را با 10 مؤلفه پاسخ در Y در پیش بینی کننده در x انجام دهید.
[xl ، yl ، xs ، ys ، beta ، pctvar ، mse ، stats] = plsregress (x ، y ، ncomp) ؛
وزن PLS نرمال شده را محاسبه کنید.
w0 = stats. w ./ sqrt (جمع (stats. w.^2،1)) ؛
نمرات VIP را برای اجزای NCOMP محاسبه کنید.
p = اندازه (xl ، 1) ؛sumsq = جمع (xs.^2،1).*جمع (yl.^2،1) ؛vipscore = sqrt (p* sum (sumsq.* (w0.^2) ، 2) ./ sum (sumsq ، 2)) ؛
متغیرهایی را با نمره VIP بیشتر از یا برابر با 1 پیدا کنید.
indVIP = find(vipScore>= 1) ؛
نمرات VIP را ترسیم کنید.
پراکندگی (1: طول (vipscore) ، vipscore ،'ایکس'))onپراکندگی (indvip ، vipscore (indvip) ،'rx') طرح ([1 طول (vipscore)] ، [1 1] ،'--k'))از رویمحورتنگxlabel ("متغیرهای پیش بینی کننده") ylabel ("نمرات VIP")
استدلال های ورودی
X - متغیرهای پیش بینی کننده ماتریس عددی
متغیرهای پیش بینی کننده ، به عنوان یک ماتریس عددی مشخص شده است. x یک ماتریس n-b y-p است ، جایی که n تعداد مشاهدات و p تعداد متغیرهای پیش بینی کننده است. هر ردیف x یک مشاهده را نشان می دهد ، و هر ستون یک متغیر را نشان می دهد. X باید همان تعداد ردیف های y را داشته باشد.
انواع داده ها: مجرد |دو برابر
Y - متغیرهای پاسخ ماتریس عددی
متغیرهای پاسخ ، به عنوان یک ماتریس عددی مشخص شده است. y یک ماتریس n-b y-m است ، جایی که n تعداد مشاهدات و m تعداد متغیرهای پاسخ است. هر ردیف y یک مشاهده را نشان می دهد ، و هر ستون یک متغیر را نشان می دهد. هر ردیف در y پاسخ برای ردیف مربوطه در x است.
انواع داده ها: مجرد |دو برابر
NCOMP - تعداد وکتور عددی مؤلفه ها
تعداد مؤلفه ها ، به عنوان یک بردار عددی مشخص شده است. اگر NCOMP را مشخص نکنید ، مقدار پیش فرض حداقل (اندازه (x ، 1) - 1 ، اندازه (x ، 2)) است.
انواع داده ها: مجرد |دو برابر
استدلال های ارزش نام
جفت آرگومان های اختیاری را به عنوان name1 = value1 مشخص کنید. namen = valuen ، که در آن نام نام و مقدار آرگومان است مقدار مربوطه است. آرگومان های ارزش نام باید پس از سایر استدلال ها ظاهر شوند ، اما ترتیب جفت ها اهمیتی ندارند.
قبل از R2021A ، از کاما برای جدا کردن هر نام و مقدار استفاده کنید و نام را در نقل قول ها محصور کنید.
مثال: "CV" ، 10 ، "گزینه ها" ، statset ('usparally' ، true) MSE را با استفاده از اعتبار سنجی متقاطع 10 برابر محاسبه می کند ، جایی که محاسبات به صورت موازی انجام می شود.
CV - روش محاسبه MSE "بازگرداندن" (پیش فرض) |عدد صحیح مثبت |موضوع CVPartition
روش محاسبه MSE ، به عنوان "تغییر مجدد" ، یک عدد صحیح مثبت یا یک شیء CVPartition مشخص شده است.
- "CV" را به عنوان "تغییر مجدد" مشخص کنید تا از هر دو x و y برای متناسب با مدل استفاده کنید و میانگین خطاهای مربع را بدون اعتبار سنجی تخمین بزنید.
- "CV" را به عنوان یک عدد صحیح مثبت K برای استفاده از اعتبار سنجی متقاطع K-fold مشخص کنید.
- برای مشخص کردن نوع دیگری از پارتیشن اعتبار سنجی متقاطع ، "CV" را به عنوان یک شی CVPartition مشخص کنید.
مثال: 'CV' ، 5
مثال: 'CV' ، CVPartition (n ، 'Holdout' ، 0. 3)
انواع داده ها: مجرد |دوتایی |چار |رشته
McReps - تعداد تکرارهای مونت کارلو 1 (پیش فرض) |عدد صحیح مثبت
تعداد تکرارهای مونت کارلو برای اعتبارسنجی متقابل ، که به عنوان یک عدد صحیح مثبت مشخص شده است. اگر "CV" را به عنوان "تغییر مجدد" مشخص کنید ، "McReps" باید 1 باشد.
مثال: "McReps" ، 5
انواع داده ها: مجرد |دو برابر
گزینه ها - گزینه هایی برای اجرا به صورت موازی و تنظیم ساختار جریان تصادفی
گزینه هایی برای اجرای محاسبات به صورت موازی و تنظیم جریان های تصادفی ، که به عنوان یک ساختار مشخص شده است. ساختار گزینه ها را با StatSet ایجاد کنید. در این جدول قسمتهای گزینه و مقادیر آنها ذکر شده است.
این مقدار را درست تنظیم کنید تا محاسبات را به صورت موازی به صورت قابل تکرار اجرا کنید.
برای محاسبه به صورت تکرار شونده ، جریان ها را به نوعی تنظیم کنید که به زیربردها اجازه می دهد: "MLFG6331_64" یا "MRG32K3A".
توجه داشته باشید
شما برای اجرای موازی به جعبه ابزار محاسباتی موازی ™ نیاز دارید.
مثال: "گزینه ها" ، statset ('usparlal' ، true)
انواع داده ها: ساختار
استدلال های خروجی
XL - ماتریس عددی بارهای پیش بینی کننده
بارهای پیش بینی کننده ، به عنوان یک ماتریس عددی بازگشت. XL یک ماتریس p-by- ncomp است ، جایی که p تعداد متغیرهای پیش بینی کننده است و NCOMP تعداد اجزای PLS است. هر ردیف XL حاوی ضرایب است که ترکیبی خطی از اجزای PLS را تقریب متغیرهای پیش بینی کننده اصلی تعریف می کند.
انواع داده ها: مجرد |دو برابر
YL - ماتریس عددی بار پاسخ
بارهای پاسخ ، به عنوان یک ماتریس عددی بازگردانده شد. YL یک ماتریس m-by- ncomp است ، جایی که m تعداد متغیرهای پاسخ است و NCOMP تعداد اجزای PLS است. هر ردیف از YL حاوی ضرایب است که ترکیبی خطی از اجزای PLS را تقریب متغیرهای پاسخ اصلی تعریف می کند.
انواع داده ها: مجرد |دو برابر
XS - پیش بینی کننده نمرات ماتریس عددی
نمرات پیش بینی کننده ، به عنوان یک ماتریس عددی بازگشت. XS یک ماتریس متعامد n-by- ncomp است ، جایی که n تعداد مشاهدات است و NCOMP تعداد اجزای PLS است. هر ردیف XS با یک مشاهده مطابقت دارد و هر ستون با یک مؤلفه مطابقت دارد.
انواع داده ها: مجرد |دو برابر
YS - نمرات پاسخ ماتریس عددی
نمرات پاسخ ، به عنوان یک ماتریس عددی بازگشت. YS یک ماتریس n-by- ncomp است ، جایی که n تعداد مشاهدات است و NCOMP تعداد اجزای PLS است. هر ردیف ys با یک مشاهده مطابقت دارد ، و هر ستون با یک مؤلفه مطابقت دارد. YS متعامد یا عادی نیست.
انواع داده ها: مجرد |دو برابر
بتا - برآورد ضریب برای ماتریس عددی رگرسیون PLS
برآورد ضریب برای رگرسیون PLS ، به عنوان یک ماتریس عددی بازگشت. بتا یک ماتریس (P + 1) -B-M است ، که در آن P تعداد متغیرهای پیش بینی کننده و M تعداد متغیرهای پاسخ است. ردیف اول بتا حاوی برآورد ضریب برای شرایط ثابت است.
انواع داده ها: مجرد |دو برابر
PCTVAR - درصد ماتریس عددی واریانس
درصد واریانس توضیح داده شده توسط مدل ، به عنوان یک ماتریس عددی بازگشت. PCTVAR یک ماتریس 2 توسط NCOMP است ، که در آن NCOMP تعداد اجزای PLS است. ردیف اول PCTVAR حاوی درصد واریانس توضیح داده شده در X توسط هر مؤلفه PLS است ، و ردیف دوم حاوی درصد واریانس توضیح داده شده در Y است.
انواع داده ها: مجرد |دو برابر
MSE - میانگین ماتریس عددی خطای مربع
میانگین خطای مربع ، به عنوان یک ماتریس عددی بازگشت. MSE یک ماتریس 2 به (NCOMP + 1) است ، که در آن NCOMP تعداد اجزای PLS است. MSE حاوی میانگین خطاهای مربع تخمین زده شده برای یک مدل PLS با اجزای NCOMP است. ردیف اول MSE حاوی میانگین خطاهای مربع برای متغیرهای پیش بینی کننده در x است ، و ردیف دوم حاوی میانگین خطاهای مربع برای متغیرهای پاسخ در y است. ستون J از MSE حاوی میانگین خطاهای مربع برای اجزای J - 1 است.
انواع داده ها: مجرد |دو برابر
آمار - ساختار آمار مدل
آمار مدل ، به عنوان یک ساختار با زمینه های شرح داده شده در این جدول بازگردانده شده است.
| رشته | شرح |
|---|---|
| W | ماتریس p-by- ncomp وزن pls به طوری که xs = x0*w |
| T2 | t 2 آماری برای هر نقطه در xs |
| xresiduals | باقیمانده های پیش بینی کننده ، x0 - xs*xl ' |
| حریم | باقیمانده پاسخ ، y0 - xs*yl ' |
برای کسب اطلاعات بیشتر در مورد متغیرهای پیش بینی کننده و پاسخ دهنده X0 و Y0 ، به الگوریتم ها مراجعه کنید.
الگوریتم
PlsRegress از الگوریتم Simples استفاده می کند [1]. تابع اول با کم کردن ستون به ترتیب برای به دست آوردن متغیرهای پیش بینی شده و پاسخ X0 و Y0 به ترتیب ، X و Y را مرکز می کند. با این حال ، عملکرد ستون ها را ذخیره نمی کند. برای انجام رگرسیون PLS با متغیرهای استاندارد ، از ZSCORE برای عادی سازی X و Y استفاده کنید (ستون های X0 و Y0 محور هستند تا میانگین 0 داشته باشند و دارای انحراف استاندارد 1 باشند).
PlsRegress پس از محوریت X و Y ، تجزیه ارزش مفرد (SVD) را در x0 '*y0 محاسبه می کند. بارهای پیش بینی کننده و پاسخ XL و YL ضرایب به دست آمده از regressing x0 و y0 در نمره پیش بینی کننده XS هستند. شما می توانید به ترتیب با استفاده از xs*xl 'و xs*yl' داده های محور x0 و y0 را بازسازی کنید.
plsregress در ابتدا Ys را به عنوان ys = y0*yl محاسبه می کند. با کنوانسیون [1] ، با این حال ، plsregress سپس هر ستون از Ys را با توجه به ستون های قبلی XS متعامد می کند ، به طوری که xs*ys یک ماتریس مثلثی پایین تر است.
منابع
[1] د جونگ ، سینمن."ساده: یک رویکرد جایگزین برای رگرسیون حداقل مربعات جزئی."شیمیایی و سیستم های آزمایشگاهی هوشمند 18 ، شماره. 3 (مارس 1993): 251-63. https://doi. org/10. 1016/0169-7439(93)85002-x.
[2] Rosipal ، Roman و Nicole Kramer."بررسی اجمالی و پیشرفت های اخیر در حداقل مربعات جزئی."فضای زیر فضای ، ساختار نهفته و انتخاب ویژگی ها: کارگاه دیدگاه آماری و بهینه سازی (SLSFS 2005) ، مقالات منتخب اصلاح شده (یادداشت های سخنرانی در علوم کامپیوتر 3940). برلین ، آلمان: Springer-Verlag ، 2006 ، جلد. 3940 ، صص 34-51. https://doi. org/10. 1007/11752790_2.
[3] Chong ، Il-Gyo و Chi-Hyuck Jun. "عملکرد برخی از روش های انتخاب متغیر در هنگام وجود چند قطبی بودن."شیمیایی و سیستم های آزمایشگاهی هوشمند 78 ، شماره. 1 2 (ژوئیه 2005) 103 12. https://doi. org/10. 1016/j. chemolab. 2004. 12. 011.
قابلیت های گسترده
پشتیبانی موازی خودکار با اجرای خودکار محاسبات به صورت موازی با استفاده از جعبه ابزار محاسباتی موازی code ، کد را تسریع کنید.
برای اجرای موازی ، آرگومان ارزش نام گزینه ها را در تماس با این عملکرد مشخص کنید و زمینه استفاده کننده ساختار گزینه ها را با استفاده از Statset تنظیم کنید:
برای اطلاعات بیشتر در مورد محاسبات موازی ، به عملکردهای MATLAB با پشتیبانی موازی خودکار (جعبه ابزار محاسبات موازی) مراجعه کنید.
تاریخچه نسخه
معرفی شده در R2008A
استراتژیهای اسکالپ...
ما را در سایت استراتژیهای اسکالپ دنبال می کنید
برچسب :
نویسنده : جعفر بدیعی
بازدید : <-PostHit->
آرشیو مطالب
خبرنامه
